Модель Jev: где она полезна продакту и маркетологу

Модель, которая не пишет ни слова, выбирает один ответ из вашего списка и сообщает, насколько уверена. Пять задач продакта и маркетолога, где это меняет работу продукта, — и публичный список мест, где модель ломается.
Модель Jev: где она полезна продакту и маркетологу
Модель, которая не пишет ни слова, выбирает один ответ из вашего списка и сообщает, насколько уверена. Пять задач продакта и маркетолога, где это меняет работу продукта, — и публичный список мест, где модель ломается.
Ваш продукт каждый день принимает решения без вас. Заявка уходит в одну очередь поддержки из четырёх, комментарий попадает на модерацию или проходит. Лид получает пометку «горячий», карточка товара от нового поставщика ложится в категорию, а в поиске наверх поднимается одна строка из тридцати.
Почти везде этот выбор делает правило, написанное руками. Есть слово «возврат» — отправить в отдел возвратов. Три восклицательных знака — пометить как срочное. Правило ловит подстроку и не читает смысл: письмо «хочу вернуть деньги за подписку, которую списали дважды» уезжает в возвраты, хотя человеку нужна бухгалтерия.
Переписать такое правило на нейросеть предлагали давно, и каждый раз спотыкались об одно и то же: модель отвечает текстом, текст надо разбирать обратно в понятные программе значения, ответ идёт секунды, стоит заметных денег на объёме, и раз в сотню запросов приходит что-то, чего в вашем списке категорий нет вовсе.
Пятнадцатого сентября 2026 года вышла модель, которая занимается ровно этим куском работы. Она не пишет ни слова. Ей дают текст и список допустимых ответов, она возвращает один ответ из этого списка и число рядом — насколько в нём уверена. Называется Jev, сделала её компания TypeSafe AI.
Список мест, где эта модель ломается, опубликовал сам производитель — он разобран ближе к концу.
Что делает модель, которая не пишет текста
Вы отдаёте модели состояние — кусок текста или набор полей: тело письма, карточку товара, переписку с клиентом, описание вакансии. Рядом кладёте один или несколько вопросов. И получаете ответы, которые программа использует сразу, без разбора и проверки.
Вопрос бывает трёх форм, и все три задаёте вы сами:
- Выбор из списка. «В какой отдел это письмо?» — и перечень отделов с описанием каждого. В ответ придёт один пункт списка, вероятность по каждому пункту и одно число, показывающее, насколько ответ однозначен. В один такой вопрос помещается до 255 вариантов, так что список отделов, категорий или товаров можно давать целиком.
- Оценка по шкале. «Насколько это срочно?» — и три-четыре ступени с описанием, что означает каждая.
- Да или нет. «В сообщении есть просьба вернуть деньги?» В ответ придёт число от нуля до единицы — вероятность, что утверждение верно. Форма называется Noul, сокращение от фамилии математика Бернулли; гендиректор TypeSafe подтвердил это в обсуждении на Hacker News.
Все вопросы к одному состоянию уходят одним запросом и считаются одновременно, поэтому добавление ещё пяти вопросов почти не меняет время ответа. TypeSafe замерила, что тринадцать вопросов к одной статье, заданные одним запросом вместо тринадцати, обошлись в 12,2 раза дешевле и прошли в 10 раз быстрее, а ответы не изменились.
Вернувшиеся значения — обычные данные: их можно сравнить с порогом, сложить с весами, положить в условие. Сам производитель описывает назначение модели словами «умные if-ы»: структурированные ответы встают в обычный код нечёткими правилами — классифицировать, направить, оценить, извлечь или разветвить там, где написанное руками условие слишком хрупкое.
Чем это отличается от большой модели, которой вы пользуетесь
Большая модель — ChatGPT, Claude, Gemini — обучена нравиться человеку и пишет строку, а строка может быть чем угодно: ответом, кодом, отказом, выдумкой. Чтобы программа строила на этом логику, строку надо разобрать и проверить, и шанс получить не то остаётся всегда.
У Jev набор возможных ответов задан заранее, поэтому ответа вне списка не бывает по устройству: придумывать модели нечем.
Скорость. Полный круг — от отправки запроса до ответа — у Jev занимает от 70 до 500 миллисекунд, у большой модели от 3 до 329 секунд. Триста миллисекунд — меньше, чем человек замечает как задержку: на таком времени решение ставят внутрь интерфейса, пока пользователь печатает. Триста секунд — это пять минут и фоновая обработка по расписанию.
Цена. Вход стоит 4,2 цента за миллион токенов, выход бесплатен. У большой модели вход стоит от 20 центов до 10 долларов за тот же миллион, а выход обычно дороже входа впятеро. Миллион токенов — примерно 700 тысяч слов русского текста, полтора-два романа.
Имя, кстати, про это же. Модель названа в честь экономиста Уильяма Стэнли Джевонса, который в XIX веке заметил: когда паровые машины стали экономичнее, угля начали жечь больше. TypeSafe ждёт того же от машинного интеллекта: каждое удешевление на порядок открывает на порядок больше мест, куда его несут.
| Большая модель (ChatGPT, Claude, Gemini) | Jev | |
|---|---|---|
| Что приходит в ответ | Текст. Может быть любым | Один вариант из вашего списка плюс число |
| Кому адресован ответ | Человеку, который прочитает | Программе, которая сразу использует |
| Время полного круга | 3–329 секунд | 70–500 миллисекунд |
| Вход, за миллион токенов | $0,20–10 | $0,042 |
| Выход | Дороже входа примерно впятеро | Бесплатно |
| Ответ вне заданного списка | Возможен | Невозможен по устройству |
| Написать текст, код, письмо | Умеет | Не умеет вовсе |
Источник: таблица сравнения в анонсе TypeSafe AI, 15 сентября 2026.
Обращения клиентов: кто разбирает входящий поток
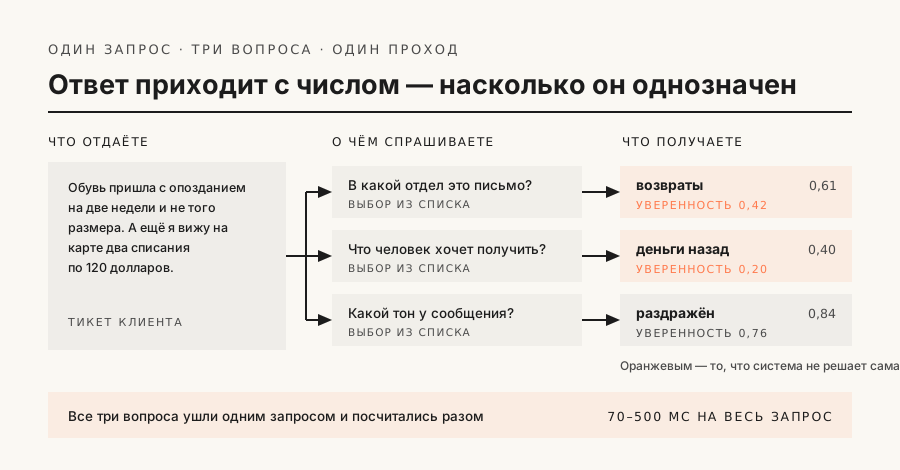
В документации TypeSafe разобран тикет, который узнает любой, кто работал с поддержкой: «Обувь пришла с опозданием на две недели и не того размера. А ещё я вижу на карте два списания по 120 долларов. Что вы с этим будете делать?» Одно сообщение, три отдела, и человек ни разу не сказал, чего хочет.
По этому тикету задали пять вопросов сразу.
| Вопрос | Ответ | Насколько однозначно |
|---|---|---|
| Какой отдел разбирает | возвраты (0,61), бухгалтерия держит 0,35 | 0,42 — тикет честно делится между двумя командами |
| Причина возврата | не тот размер | 1,0 — в тексте сказано прямо |
| Что человек хочет получить | деньги назад (0,40), обмен и замена делят остальное | 0,20 — человек не сказал |
| Тон сообщения | раздражён (0,84) | 0,76 |
Модель сообщила, что выбор отдела шаткий, и отдельно сообщила, что про желаемый исход в тикете нет ничего. На этих двух числах строится вся развилка: причину возврата можно проставлять автоматически, а решать за клиента, деньги ему или обмен, — нельзя, и система знает об этом заранее.
Схема маршрутизации, которую показывает сама TypeSafe: модель классифицирует обращение и оценивает сложность, а код разводит потоки. «Где мой заказ» уходит в обычный запрос к базе, без всякого ИИ. Вопрос о товаре и просьба о возврате — к двум разным большим моделям, у каждой свой контекст. Жалоба выше определённой сложности или любой ответ с низкой уверенностью — человеку. Дорогие инструменты включаются только там, где они нужны.
Нихил Мудхолкар, технический директор Bryo AI, прогнал разбор деловой переписки и сообщил, что Gemini справляется чуть точнее и стоит при этом в 10–20 раз дороже.
Лиды и кандидаты: оценка по критериям, которые задаёте вы
Лид, отклик на вакансию, входящее письмо от компании: нужно понять, насколько это ваше, и выстроить очередь.
Обычно такую оценку пробуют получить одним запросом: «оцени этот лид от 1 до 10». Ответ приходит, объяснить его невозможно, и при смене приоритетов приходится переписывать формулировку и заново гадать, что она делает.
TypeSafe предлагает разложить суждение на части. В документации это сформулировано прямо: вместо «оцени этот питч стартапа» спрашивайте отдельно про размер рынка, техническую выполнимость и отстройку от конкурентов, а потом сложите оценки своей формулой. Каждый вопрос маленький, ответ на него модель даёт уверенно, а веса живут в вашем коде.
Продуктовая работа начинается там, где вы задаёте веса. Разбор составной оценки показывает это на резюме: четыре измерения приводятся к шкале от нуля до единицы, и дальше две разные формулы под две разные роли. Для сильного инженера глубина в языке весит 0,40 и системное проектирование 0,40, руководство командой — 0,10. Для руководителя направления те же четыре числа складываются иначе: руководство весит 0,40, глубина в языке падает до 0,15.
Ту же механику прикладывают к лидам: соответствие профилю идеального клиента, зрелость компании, признаки боли, признаки готовности покупать — четыре отдельных вопроса и одна формула, которую вы правите руками, когда отдел продаж жалуется, что очередь идёт не тем порядком.
Симон Уиллисон, один из самых читаемых независимых разработчиков в теме ИИ, написал по поводу ровно этого сценария: «Я очень надеюсь, что никто не станет использовать Jev для ранжирования кандидатов на работу». Его довод — модель возвращает число и молчит о том, что на него повлияло; перекос, зашитый в обучение, вытащить наружу экспериментом трудно.
Производитель предлагает отбор резюме как образцовый пример. Независимый разработчик про тот же сценарий предупреждает. Оба говорят из первых рук, и решение остаётся за тем, кто ставит систему. Держите такую оценку подсказкой для человека и сохраняйте каждое измерение в журнале, чтобы решение можно было разобрать потом.
Поиск и каталог: когда нужно сопоставить смысл
Поиск по словам находит то, что написано теми же словами. Пользователь спрашивает «можно ли отменить подписку после списания», а в базе знаний статья называется «Условия расторжения договора» — совпадений нет, человек уходит в поддержку.
Приём, который здесь работает, Уиллисон описывает так: сначала обычным дешёвым алгоритмом достаём сотню похожих кандидатов, потом прогоняем каждого через модель с вопросом «насколько этот текст отвечает на запрос». Сотня вопросов в одном запросе идёт параллельно, так что стоит это центы.
У самой TypeSafe этот прогон опубликован с цифрами. В их кукбуке по переранжированию на сорока юридических запросах брали по 30 кандидатов, найденных обычным поиском по словам, и переупорядочивали моделью: доля запросов, где нужный документ оказался первым, выросла с 5% до 18%, доля попаданий в первую десятку — с 38% до 62%. Цифры вендорские, набор английский, а стартовые 5% говорят о том, что базовый поиск на этом наборе работал плохо. Порядок улучшения проверяется только на своих данных.
С каталогом та же история в другом виде. Задача «это тот же товар или другой» стоит перед всеми, кто сводит поставщиков в одну витрину: у одного «Кроссовки Nike Air Max 90 белые 42», у другого «NIKE AirMax90 White EU42». В разборе сопоставления записей TypeSafe берёт 450 пар кандидатов из двух каталогов пива и задаёт по каждой паре одну оценку плюс три вопроса «да/нет», которые показывают, какие именно поля разошлись. Вы видите, что расходится производитель или расходится объём, и разводите эти случаи разными правилами.
В списке применений по отраслям у TypeSafe маркетплейсы стоят отдельной строкой: привести к общему виду карточки из разнородных каталогов продавцов, вытащить характеристики из названий, поймать запрещённые товары и накрутку отзывов.
Модерация и контроль: что пропустить, что показать человеку
Любой, кто держал сообщество, знает цикл: сначала стоп-слова, потом обход стоп-слов, потом список исключений к стоп-словам, потом модератор, который каждый вечер разбирает то, что список не поймал. Правило ловит написание, люди пишут иначе.
Здесь описание нарушения задаётся своими словами и живёт как критерий. Кукбук по ограждениям показывает схему на четыре исхода: пропустить, показать человеку, заблокировать, увести в отдельный поток. Решение принимается по двум числам сразу — насколько серьёзно нарушение и насколько модель в нём уверена. Оскорбление, в котором она уверена, блокируется само; пограничный случай уходит модератору с уже проставленной пометкой, по какому признаку он пограничный.
Отдельный сюжет — контроль за тем, что делают ИИ-агенты, если вы их уже завели. Инструмент jev-guard ставит на каждое действие агента одну из трёх пометок: запретить, спросить у человека, разрешить. В Vercel эту же идею приложили к проверке команд перед выполнением: Гильермо Раух, гендиректор компании, сообщил, что на этой проверке Jev оказался до 18 раз быстрее по верхней границе задержки, чем стоявшая там раньше модель, и при этом точнее.
Производитель прямо пишет, что модель не считает присланный текст враждебным по умолчанию: сообщение, написанное так, чтобы сдвинуть оценку в свою сторону, её сдвигает. Для модерации это означает, что попытки обхода никуда не денутся — поменяется их форма.
Интерфейс, который решает на лету
Когда ответ приходит за треть секунды, решение принимается во время действия пользователя, а не после него.
Стив Краус собрал демонстрацию, где шестнадцать суждений о тексте пересчитываются, пока человек печатает, — посмотреть можно здесь. За первую неделю сообщество принесло ещё несколько таких вещей: расширение, которое пропускает рекламные вставки внутри ролика на YouTube; фильтр, убирающий грубые комментарии из чата в реальном времени; поиск по почте по смыслу просьбы; поиск по странице, который понимает формулировку живым языком. Бен Тосселл собрал подборку — там около сотни таких вещей, сделанных за неделю.
Агентам скорость реакции нужна ещё острее. Команда Browser Use выпустила jev-ultrafast: браузерный агент проходит поиск рейса Цюрих — Лондон в Google Flights за 7,1 секунды. В Droidrun сделали то же для телефона: агент водит Uber на живом Android, девять действий примерно за 21 секунду. Бронирование, впрочем, там доведено не было, и авторы об этом говорят прямо.
Замер оставила сама TypeSafe в демонстрации с Doom: инженер, который её собирал, беспокоился о десяти запросах в секунду — это выходит примерно семь долларов за час игры. От этой цифры удобно отталкиваться, прикидывая свой сценарий: столько стоит непрерывное принятие решений в реальном времени.
Микрорешения, которые раньше жили в голове у пользователя, можно забрать в продукт: куда положить этот файл, какой из трёх шаблонов подставить, стоит ли предупредить, пока человек не отправил. Каждое по отдельности мелкое, вместе они и составляют разницу между «удобно» и «неудобно».
Уверенность: главная ручка, которую крутит продакт
Число рядом с ответом показывает, насколько выбор однозначен. Считается оно из формы распределения: вся вероятность собралась на одном варианте — число близко к единице; вероятность размазалась по трём — число низкое. В тикете про обувь уверенность по отделу вышла 0,42, потому что тикет честно принадлежал двум командам сразу.
Дальше вы решаете, что с этим делать. Документация предлагает три диапазона: высокая уверенность — действовать без человека; средняя — попросить подтверждение или собрать данных; низкая — не действовать вовсе, отдать человеку или переспросить.
Где провести границы между диапазонами — это и есть продуктовое решение. Причём границ должно быть несколько, по одной на каждое действие, и зависят они от цены ошибки. В примере из документации разобран банковский случай: показать баланс счёта и подтвердить перевод денег гарантируются по-разному. Показать не тот экран — ошибка, которую человек исправляет одним нажатием, там достаточно любой уверенности выше нижнего порога. Провести перевод — ошибка, которую откатывать долго, там порог поднят до 0,9, а всё, что ниже, уходит на подтверждение пользователю.
Переведите это на свой продукт, и получится таблица, которую вы как продакт соберёте сегодня, без единой строчки кода.
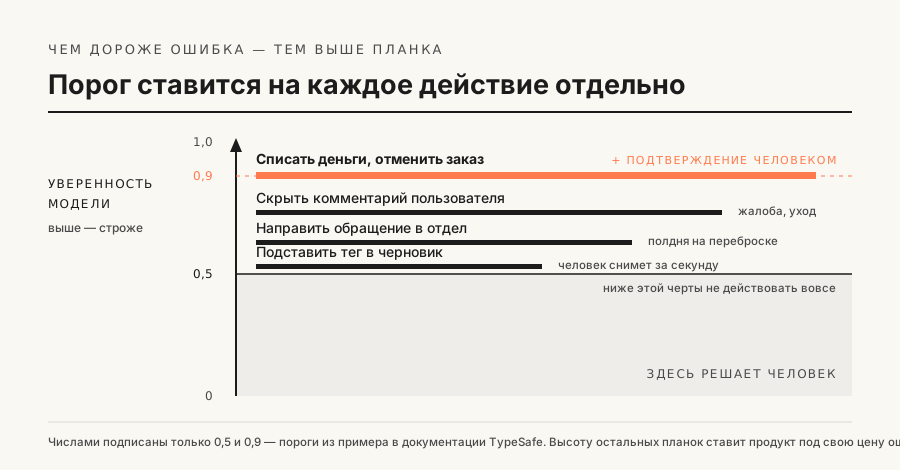
| Действие в продукте | Что будет, если ошиблись | Порог |
|---|---|---|
| Подставить тег в черновик | Человек снимет тег за секунду | низкий |
| Направить обращение в отдел | Обращение потеряет полдня на переброске | средний |
| Скрыть комментарий пользователя | Пользователь напишет жалобу и, возможно, уйдёт | высокий |
| Списать деньги, отменить заказ | Возврат, объяснения, репутация | очень высокий, плюс подтверждение человеком |
Пороги берутся из ваших же данных, а не из головы. Прогоняете двести своих строк, смотрите, при каком значении ошибки становятся редкими, ставите порог туда. Прогон двухсот строк стоит центы.
Низкая уверенность при этом — полезный ответ. Она означает, что во входных данных действительно не хватает информации, и это часто ценнее самого решения: если в половине тикетов модель не может понять, чего хочет клиент, проблема живёт в форме обращения. На разметке больших массивов из этого вырастает отдельный приём: в разборе классификации годовых отчётов компании раскладывают по 75 отраслевым группам, и при неуверенном ответе система возвращает более широкий раздел над группой. Там, где данных не хватило, стоит грубая метка вместо выдуманной точной.
Где он ломается
Список изъянов опубликовал сам производитель. У TypeSafe есть страница «Шероховатости jev-1.13» с девятью режимами отказа, датой последней проверки и рекомендацией по каждому. Читать её стоит раньше, чем маркетинговую страницу.
Два ограничения видно ещё до неё. Модель работает только с текстом: картинки, звук и видео надо сначала во что-то превратить. Весов, числа параметров и способа поднять её у себя TypeSafe не публиковала — это размещённый API, данные уходят на их серверы.
| Где ломается | Что происходит | Что делать |
|---|---|---|
| Счёт | Символы в слове, вхождения в тексте, элементы списка считаются неточно, и ошибка растёт вместе с размером | Считать в коде: задать по вопросу на каждый элемент и сложить ответы самостоятельно |
| Даты | Читаются как текст, а не как упорядоченные величины: что раньше, сколько прошло, попадает ли в квартал — ненадёжно | Поручить модели вытащить месяц, число и год; арифметику оставить коду |
| Буквальность | Модель отвечает на вопрос, который вы написали, а не на тот, который имели в виду | Если, глядя на неверный ответ, вы объясняете, что на самом деле хотели спросить, — это объяснение и есть недостающая половина вопроса |
| Много лишнего в тексте | Точность падает, и труднее понять, какой кусок ответ испортил. В запрос помещается 64 тысячи токенов | Отправлять только то, что относится к вопросу |
| Арифметика между ответами | «Клиент просит вернуть деньги» и обратный ему «клиент просит что-то другое» на одном тикете дали 0,72 и 0,47 — в сумме 1,19 | Порог, подобранный на одной форме вопроса, на другую не переносить |
| Генерация текста | Модель не пишет строк совсем | Для всего, где нужен текст, ставить рядом большую модель |
Источник: документация TypeSafe, страница о слабых местах jev-1.13, проверка от 17 сентября 2026.
Про «ноль галлюцинаций»
Эту формулировку стоит развести на две, потому что в пересказах они слиплись. Первое утверждение: модель не может вернуть вариант, которого нет в вашем списке. Это верно, и опровергается оно одним случаем, когда так не вышло. Второе утверждение: выбранный вариант верен. Из первого оно не следует.
Сама TypeSafe пишет об этом прямо — ноль в их графике выведен из гарантии соответствия схеме, а не измерен на данных. В русскоязычном поле за первую неделю эту разницу оговорил один автор — Александр Горный.
Сюда же — замечание Уиллисона про чёрный ящик. Большую модель можно попросить объяснить ответ, и объяснение хотя бы будет. Jev возвращает число и молчит: если она пометила сообщение как спам, какие именно слова её к этому склонили, вы не узнаете.
Откуда берутся «в 193 раза быстрее»
Цифры 193,6 и 444,6 стоят на главной странице TypeSafe, и компания сама расшифровывает их в анонсе. Получены они на собственном наборе рабочих сценариев, эталонным ответом там считается среднее двух самых дорогих моделей рынка, а сценарии писала команда самой TypeSafe — об этом сказано в тексте, с оговоркой, что перекос возможен. И там же: «мы ожидаем, что это верхняя граница выигрыша в реальной работе». Отдельной строкой компания признаёт: доказать, что цена не субсидируется, она не может.
Сравнивать такие цифры стоит только со своим прогоном на своих данных. Благо это дёшево: как замечает Уиллисон, тысяча пробных запросов обходится в несколько центов.
- 01
Выпишите места, где решает правило
Пройдите по продукту и найдите каждую точку, где что-то выбирается: куда уходит обращение, что скрывается, что поднимается наверх, что помечается. Рядом с каждой — как решение принимается сейчас.
- 02
Выберите одно место, где правило ошибается чаще всего
То, про которое поддержка или модераторы говорят каждую неделю. Не самое важное — самое раздражающее.
- 03
Переформулируйте его в вопрос с готовым списком ответов
Одна из трёх форм: выбрать из списка, оценить по шкале, ответить да или нет. Если вопрос требует взвесить несколько вещей сразу — разбейте на несколько, по одному на каждую.
- 04
Соберите 100–200 своих строк с известным правильным ответом
Реальные тикеты, комментарии, лиды. Разметка уже есть — её сделали ваши же сотрудники за прошлый месяц.
- 05
Прогоните и сравните с текущим правилом на тех же строках
Прогон обойдётся в центы. Сравнивать нужно с тем, что стоит у вас сейчас: вендорские цифры получены на английских наборах и на чужих сценариях.
- 06
Поставьте пороги по цене ошибки
Для каждого действия отдельно, по таблице из раздела про уверенность. Начинайте с осторожных значений и опускайте по мере того, как накапливается статистика.
- 07
Ведите журнал
На каждое решение пишите ответ, вероятности и порог, который сработал. Без этого разобрать спорный случай через месяц будет нечем — модель объяснений не даёт.
Джон Берриман из Arcturus Labs разобрал, что OpenAI годами использует свои модели как скрытые классификаторы внутри собственных продуктов, и повторить такой сервис им технически несложно. Единственная защита, которую он у TypeSafe видит, — обучающие данные и способ обучения. Это довод в пользу того, чтобы строить у себя развилку на понятном интерфейсе, не привязываясь к одному поставщику.
За первую неделю появились открытые проекты того же класса, работающие на своём железе. Все они моложе десяти дней, и брать их в работу стоит с поправкой на возраст.

AnyJev
библиотека от исследовательского подразделения Nokia под лицензией Apache 2.0. Превращает любую открытую языковую модель в модель решений без дообучения и по дороге чинит два известных перекоса: тягу модели к отдельным вариантам независимо от текста и тягу к определённым позициям в списке.
Перейти →
Laya
открытая модель решений на 421 млн параметров, помещается меньше чем в гигабайт памяти. На MacBook с процессором M4 без подключения к сети даёт около 45 решений в секунду.
Перейти →
Kev
семейство моделей решений на базе Qwen 3.5 в трёх размерах: 0,8, 4 и 9 миллиардов параметров.
Перейти →
JevBench
открытый бенчмарк, сравнивающий модели этого класса разом по точности, задержке и цене; прогон состоит из 534 решений. Ограничения автор называет сам: только английский язык и замер задержки с одного сервера в Германии.
Перейти →Часто задаваемые вопросы
- Чем Jev отличается от ChatGPT простыми словами?
ChatGPT пишет текст для человека, Jev выбирает один вариант из списка для программы. Ответа вне заданного списка Jev выдать не может по устройству, зато написать письмо или код она не умеет вовсе. Разница в скорости — 70–500 миллисекунд против 3–329 секунд; в цене входа — 4,2 цента за миллион токенов против 20 центов и выше.
- Правда ли, что Jev не галлюцинирует?
Гарантия здесь одна: модель не вернёт вариант, которого нет в вашем списке. Выбранный вариант при этом может быть неверным. Сама TypeSafe пишет, что ноль в их графике выведен из гарантии соответствия схеме, а не измерен на данных.
- Сколько это будет стоить на реальном объёме?
Вход стоит 4,2 цента за миллион токенов, выход бесплатен. Миллион токенов — примерно 700 тысяч слов. В демонстрации TypeSafe с игрой десять запросов в секунду обходились примерно в семь долларов за час непрерывной работы. Свою цифру считайте по своему объёму текста, а не по числу решений.
- Можно ли работать с Jev, не отправляя данные за границу?
С самим Jev — нет: это размещённый API, весов компания не публиковала. Для работы на своём железе есть открытые проекты того же класса: AnyJev от Nokia, Laya, Kev. Все они вышли в сентябре 2026 года, и зрелости у них соответствующая.
- Заменит ли такая модель большие нейросети в продукте?
Они делают разную работу и обычно стоят рядом. Типовая схема выглядит так: быстрая модель решений разбирает входящее и решает, куда его отправить, а большая модель включается только там, где нужен связный текст. В примере маршрутизации от TypeSafe из четырёх типов обращений до большой модели доходят два.
- С чего начать, если я не программист?
С первых двух шагов инструкции выше — их можно сделать без кода. Выпишите места в продукте, где решение принимает жёсткое правило, и отметьте то, где оно ошибается чаще всего. Этот список и есть техническое задание на проверку; дальше нужен человек, который прогонит двести ваших строк.
Список мест в продукте, где решение принимает жёсткое правило, полезен независимо от того, поставите вы туда модель, оставите правило или перепишете форму обращения, чтобы вопрос отпал. Этот список почти никогда не существует в явном виде: правила накапливаются годами, каждое кажется мелочью, и в сумме они определяют, каким продукт выглядит для пользователя. Час работы на такую опись окупается сам по себе.
А дальше дело за ценой. Пока одно решение стоило секунды и заметных денег, спорить о точности не приходилось: проще было оставить правило. При четырёх центах за миллион токенов двести своих строк вы прогоняете за вечер, и разговор переходит из области мнений в область замера.
Если хотите посмотреть, где в этой картине находитесь вы и ваша команда, — у нас есть карта уровней вайбкодинга с коротким тестом: пять ступеней от «собрал лендинг за вечер» до «держу собственные сервисы и агентов».
Ваш продукт каждый день принимает решения без вас. Заявка уходит в одну очередь поддержки из четырёх, комментарий попадает на модерацию или проходит. Лид получает пометку «горячий», карточка товара от нового поставщика ложится в категорию, а в поиске наверх поднимается одна строка из тридцати.
Почти везде этот выбор делает правило, написанное руками. Есть слово «возврат» — отправить в отдел возвратов. Три восклицательных знака — пометить как срочное. Правило ловит подстроку и не читает смысл: письмо «хочу вернуть деньги за подписку, которую списали дважды» уезжает в возвраты, хотя человеку нужна бухгалтерия.
Переписать такое правило на нейросеть предлагали давно, и каждый раз спотыкались об одно и то же: модель отвечает текстом, текст надо разбирать обратно в понятные программе значения, ответ идёт секунды, стоит заметных денег на объёме, и раз в сотню запросов приходит что-то, чего в вашем списке категорий нет вовсе.
Пятнадцатого сентября 2026 года вышла модель, которая занимается ровно этим куском работы. Она не пишет ни слова. Ей дают текст и список допустимых ответов, она возвращает один ответ из этого списка и число рядом — насколько в нём уверена. Называется Jev, сделала её компания TypeSafe AI.
Список мест, где эта модель ломается, опубликовал сам производитель — он разобран ближе к концу.
Что делает модель, которая не пишет текста
Вы отдаёте модели состояние — кусок текста или набор полей: тело письма, карточку товара, переписку с клиентом, описание вакансии. Рядом кладёте один или несколько вопросов. И получаете ответы, которые программа использует сразу, без разбора и проверки.
Вопрос бывает трёх форм, и все три задаёте вы сами:
- Выбор из списка. «В какой отдел это письмо?» — и перечень отделов с описанием каждого. В ответ придёт один пункт списка, вероятность по каждому пункту и одно число, показывающее, насколько ответ однозначен. В один такой вопрос помещается до 255 вариантов, так что список отделов, категорий или товаров можно давать целиком.
- Оценка по шкале. «Насколько это срочно?» — и три-четыре ступени с описанием, что означает каждая.
- Да или нет. «В сообщении есть просьба вернуть деньги?» В ответ придёт число от нуля до единицы — вероятность, что утверждение верно. Форма называется Noul, сокращение от фамилии математика Бернулли; гендиректор TypeSafe подтвердил это в обсуждении на Hacker News.
Все вопросы к одному состоянию уходят одним запросом и считаются одновременно, поэтому добавление ещё пяти вопросов почти не меняет время ответа. TypeSafe замерила, что тринадцать вопросов к одной статье, заданные одним запросом вместо тринадцати, обошлись в 12,2 раза дешевле и прошли в 10 раз быстрее, а ответы не изменились.
Вернувшиеся значения — обычные данные: их можно сравнить с порогом, сложить с весами, положить в условие. Сам производитель описывает назначение модели словами «умные if-ы»: структурированные ответы встают в обычный код нечёткими правилами — классифицировать, направить, оценить, извлечь или разветвить там, где написанное руками условие слишком хрупкое.
Чем это отличается от большой модели, которой вы пользуетесь
Большая модель — ChatGPT, Claude, Gemini — обучена нравиться человеку и пишет строку, а строка может быть чем угодно: ответом, кодом, отказом, выдумкой. Чтобы программа строила на этом логику, строку надо разобрать и проверить, и шанс получить не то остаётся всегда.
У Jev набор возможных ответов задан заранее, поэтому ответа вне списка не бывает по устройству: придумывать модели нечем.
Скорость. Полный круг — от отправки запроса до ответа — у Jev занимает от 70 до 500 миллисекунд, у большой модели от 3 до 329 секунд. Триста миллисекунд — меньше, чем человек замечает как задержку: на таком времени решение ставят внутрь интерфейса, пока пользователь печатает. Триста секунд — это пять минут и фоновая обработка по расписанию.
Цена. Вход стоит 4,2 цента за миллион токенов, выход бесплатен. У большой модели вход стоит от 20 центов до 10 долларов за тот же миллион, а выход обычно дороже входа впятеро. Миллион токенов — примерно 700 тысяч слов русского текста, полтора-два романа.
Имя, кстати, про это же. Модель названа в честь экономиста Уильяма Стэнли Джевонса, который в XIX веке заметил: когда паровые машины стали экономичнее, угля начали жечь больше. TypeSafe ждёт того же от машинного интеллекта: каждое удешевление на порядок открывает на порядок больше мест, куда его несут.
| Большая модель (ChatGPT, Claude, Gemini) | Jev | |
|---|---|---|
| Что приходит в ответ | Текст. Может быть любым | Один вариант из вашего списка плюс число |
| Кому адресован ответ | Человеку, который прочитает | Программе, которая сразу использует |
| Время полного круга | 3–329 секунд | 70–500 миллисекунд |
| Вход, за миллион токенов | $0,20–10 | $0,042 |
| Выход | Дороже входа примерно впятеро | Бесплатно |
| Ответ вне заданного списка | Возможен | Невозможен по устройству |
| Написать текст, код, письмо | Умеет | Не умеет вовсе |
Источник: таблица сравнения в анонсе TypeSafe AI, 15 сентября 2026.
Обращения клиентов: кто разбирает входящий поток
В документации TypeSafe разобран тикет, который узнает любой, кто работал с поддержкой: «Обувь пришла с опозданием на две недели и не того размера. А ещё я вижу на карте два списания по 120 долларов. Что вы с этим будете делать?» Одно сообщение, три отдела, и человек ни разу не сказал, чего хочет.
По этому тикету задали пять вопросов сразу.
| Вопрос | Ответ | Насколько однозначно |
|---|---|---|
| Какой отдел разбирает | возвраты (0,61), бухгалтерия держит 0,35 | 0,42 — тикет честно делится между двумя командами |
| Причина возврата | не тот размер | 1,0 — в тексте сказано прямо |
| Что человек хочет получить | деньги назад (0,40), обмен и замена делят остальное | 0,20 — человек не сказал |
| Тон сообщения | раздражён (0,84) | 0,76 |
Модель сообщила, что выбор отдела шаткий, и отдельно сообщила, что про желаемый исход в тикете нет ничего. На этих двух числах строится вся развилка: причину возврата можно проставлять автоматически, а решать за клиента, деньги ему или обмен, — нельзя, и система знает об этом заранее.
Схема маршрутизации, которую показывает сама TypeSafe: модель классифицирует обращение и оценивает сложность, а код разводит потоки. «Где мой заказ» уходит в обычный запрос к базе, без всякого ИИ. Вопрос о товаре и просьба о возврате — к двум разным большим моделям, у каждой свой контекст. Жалоба выше определённой сложности или любой ответ с низкой уверенностью — человеку. Дорогие инструменты включаются только там, где они нужны.
Нихил Мудхолкар, технический директор Bryo AI, прогнал разбор деловой переписки и сообщил, что Gemini справляется чуть точнее и стоит при этом в 10–20 раз дороже.
Лиды и кандидаты: оценка по критериям, которые задаёте вы
Лид, отклик на вакансию, входящее письмо от компании: нужно понять, насколько это ваше, и выстроить очередь.
Обычно такую оценку пробуют получить одним запросом: «оцени этот лид от 1 до 10». Ответ приходит, объяснить его невозможно, и при смене приоритетов приходится переписывать формулировку и заново гадать, что она делает.
TypeSafe предлагает разложить суждение на части. В документации это сформулировано прямо: вместо «оцени этот питч стартапа» спрашивайте отдельно про размер рынка, техническую выполнимость и отстройку от конкурентов, а потом сложите оценки своей формулой. Каждый вопрос маленький, ответ на него модель даёт уверенно, а веса живут в вашем коде.
Продуктовая работа начинается там, где вы задаёте веса. Разбор составной оценки показывает это на резюме: четыре измерения приводятся к шкале от нуля до единицы, и дальше две разные формулы под две разные роли. Для сильного инженера глубина в языке весит 0,40 и системное проектирование 0,40, руководство командой — 0,10. Для руководителя направления те же четыре числа складываются иначе: руководство весит 0,40, глубина в языке падает до 0,15.
Ту же механику прикладывают к лидам: соответствие профилю идеального клиента, зрелость компании, признаки боли, признаки готовности покупать — четыре отдельных вопроса и одна формула, которую вы правите руками, когда отдел продаж жалуется, что очередь идёт не тем порядком.
Симон Уиллисон, один из самых читаемых независимых разработчиков в теме ИИ, написал по поводу ровно этого сценария: «Я очень надеюсь, что никто не станет использовать Jev для ранжирования кандидатов на работу». Его довод — модель возвращает число и молчит о том, что на него повлияло; перекос, зашитый в обучение, вытащить наружу экспериментом трудно.
Производитель предлагает отбор резюме как образцовый пример. Независимый разработчик про тот же сценарий предупреждает. Оба говорят из первых рук, и решение остаётся за тем, кто ставит систему. Держите такую оценку подсказкой для человека и сохраняйте каждое измерение в журнале, чтобы решение можно было разобрать потом.
Поиск и каталог: когда нужно сопоставить смысл
Поиск по словам находит то, что написано теми же словами. Пользователь спрашивает «можно ли отменить подписку после списания», а в базе знаний статья называется «Условия расторжения договора» — совпадений нет, человек уходит в поддержку.
Приём, который здесь работает, Уиллисон описывает так: сначала обычным дешёвым алгоритмом достаём сотню похожих кандидатов, потом прогоняем каждого через модель с вопросом «насколько этот текст отвечает на запрос». Сотня вопросов в одном запросе идёт параллельно, так что стоит это центы.
У самой TypeSafe этот прогон опубликован с цифрами. В их кукбуке по переранжированию на сорока юридических запросах брали по 30 кандидатов, найденных обычным поиском по словам, и переупорядочивали моделью: доля запросов, где нужный документ оказался первым, выросла с 5% до 18%, доля попаданий в первую десятку — с 38% до 62%. Цифры вендорские, набор английский, а стартовые 5% говорят о том, что базовый поиск на этом наборе работал плохо. Порядок улучшения проверяется только на своих данных.
С каталогом та же история в другом виде. Задача «это тот же товар или другой» стоит перед всеми, кто сводит поставщиков в одну витрину: у одного «Кроссовки Nike Air Max 90 белые 42», у другого «NIKE AirMax90 White EU42». В разборе сопоставления записей TypeSafe берёт 450 пар кандидатов из двух каталогов пива и задаёт по каждой паре одну оценку плюс три вопроса «да/нет», которые показывают, какие именно поля разошлись. Вы видите, что расходится производитель или расходится объём, и разводите эти случаи разными правилами.
В списке применений по отраслям у TypeSafe маркетплейсы стоят отдельной строкой: привести к общему виду карточки из разнородных каталогов продавцов, вытащить характеристики из названий, поймать запрещённые товары и накрутку отзывов.
Модерация и контроль: что пропустить, что показать человеку
Любой, кто держал сообщество, знает цикл: сначала стоп-слова, потом обход стоп-слов, потом список исключений к стоп-словам, потом модератор, который каждый вечер разбирает то, что список не поймал. Правило ловит написание, люди пишут иначе.
Здесь описание нарушения задаётся своими словами и живёт как критерий. Кукбук по ограждениям показывает схему на четыре исхода: пропустить, показать человеку, заблокировать, увести в отдельный поток. Решение принимается по двум числам сразу — насколько серьёзно нарушение и насколько модель в нём уверена. Оскорбление, в котором она уверена, блокируется само; пограничный случай уходит модератору с уже проставленной пометкой, по какому признаку он пограничный.
Отдельный сюжет — контроль за тем, что делают ИИ-агенты, если вы их уже завели. Инструмент jev-guard ставит на каждое действие агента одну из трёх пометок: запретить, спросить у человека, разрешить. В Vercel эту же идею приложили к проверке команд перед выполнением: Гильермо Раух, гендиректор компании, сообщил, что на этой проверке Jev оказался до 18 раз быстрее по верхней границе задержки, чем стоявшая там раньше модель, и при этом точнее.
Производитель прямо пишет, что модель не считает присланный текст враждебным по умолчанию: сообщение, написанное так, чтобы сдвинуть оценку в свою сторону, её сдвигает. Для модерации это означает, что попытки обхода никуда не денутся — поменяется их форма.
Интерфейс, который решает на лету
Когда ответ приходит за треть секунды, решение принимается во время действия пользователя, а не после него.
Стив Краус собрал демонстрацию, где шестнадцать суждений о тексте пересчитываются, пока человек печатает, — посмотреть можно здесь. За первую неделю сообщество принесло ещё несколько таких вещей: расширение, которое пропускает рекламные вставки внутри ролика на YouTube; фильтр, убирающий грубые комментарии из чата в реальном времени; поиск по почте по смыслу просьбы; поиск по странице, который понимает формулировку живым языком. Бен Тосселл собрал подборку — там около сотни таких вещей, сделанных за неделю.
Агентам скорость реакции нужна ещё острее. Команда Browser Use выпустила jev-ultrafast: браузерный агент проходит поиск рейса Цюрих — Лондон в Google Flights за 7,1 секунды. В Droidrun сделали то же для телефона: агент водит Uber на живом Android, девять действий примерно за 21 секунду. Бронирование, впрочем, там доведено не было, и авторы об этом говорят прямо.
Замер оставила сама TypeSafe в демонстрации с Doom: инженер, который её собирал, беспокоился о десяти запросах в секунду — это выходит примерно семь долларов за час игры. От этой цифры удобно отталкиваться, прикидывая свой сценарий: столько стоит непрерывное принятие решений в реальном времени.
Микрорешения, которые раньше жили в голове у пользователя, можно забрать в продукт: куда положить этот файл, какой из трёх шаблонов подставить, стоит ли предупредить, пока человек не отправил. Каждое по отдельности мелкое, вместе они и составляют разницу между «удобно» и «неудобно».
«Если модель справляется с задачей в 95% случаев, но не сообщает, когда попала в оставшиеся 5%, эту задачу она автоматизировать не может.»— https://typesafe.ai/blog/introducing-system-one-models-and-jev
Уверенность: главная ручка, которую крутит продакт
Число рядом с ответом показывает, насколько выбор однозначен. Считается оно из формы распределения: вся вероятность собралась на одном варианте — число близко к единице; вероятность размазалась по трём — число низкое. В тикете про обувь уверенность по отделу вышла 0,42, потому что тикет честно принадлежал двум командам сразу.
Дальше вы решаете, что с этим делать. Документация предлагает три диапазона: высокая уверенность — действовать без человека; средняя — попросить подтверждение или собрать данных; низкая — не действовать вовсе, отдать человеку или переспросить.
Где провести границы между диапазонами — это и есть продуктовое решение. Причём границ должно быть несколько, по одной на каждое действие, и зависят они от цены ошибки. В примере из документации разобран банковский случай: показать баланс счёта и подтвердить перевод денег гарантируются по-разному. Показать не тот экран — ошибка, которую человек исправляет одним нажатием, там достаточно любой уверенности выше нижнего порога. Провести перевод — ошибка, которую откатывать долго, там порог поднят до 0,9, а всё, что ниже, уходит на подтверждение пользователю.
Переведите это на свой продукт, и получится таблица, которую вы как продакт соберёте сегодня, без единой строчки кода.
| Действие в продукте | Что будет, если ошиблись | Порог |
|---|---|---|
| Подставить тег в черновик | Человек снимет тег за секунду | низкий |
| Направить обращение в отдел | Обращение потеряет полдня на переброске | средний |
| Скрыть комментарий пользователя | Пользователь напишет жалобу и, возможно, уйдёт | высокий |
| Списать деньги, отменить заказ | Возврат, объяснения, репутация | очень высокий, плюс подтверждение человеком |
Пороги берутся из ваших же данных, а не из головы. Прогоняете двести своих строк, смотрите, при каком значении ошибки становятся редкими, ставите порог туда. Прогон двухсот строк стоит центы.
Низкая уверенность при этом — полезный ответ. Она означает, что во входных данных действительно не хватает информации, и это часто ценнее самого решения: если в половине тикетов модель не может понять, чего хочет клиент, проблема живёт в форме обращения. На разметке больших массивов из этого вырастает отдельный приём: в разборе классификации годовых отчётов компании раскладывают по 75 отраслевым группам, и при неуверенном ответе система возвращает более широкий раздел над группой. Там, где данных не хватило, стоит грубая метка вместо выдуманной точной.
Где он ломается
Список изъянов опубликовал сам производитель. У TypeSafe есть страница «Шероховатости jev-1.13» с девятью режимами отказа, датой последней проверки и рекомендацией по каждому. Читать её стоит раньше, чем маркетинговую страницу.
Два ограничения видно ещё до неё. Модель работает только с текстом: картинки, звук и видео надо сначала во что-то превратить. Весов, числа параметров и способа поднять её у себя TypeSafe не публиковала — это размещённый API, данные уходят на их серверы.
| Где ломается | Что происходит | Что делать |
|---|---|---|
| Счёт | Символы в слове, вхождения в тексте, элементы списка считаются неточно, и ошибка растёт вместе с размером | Считать в коде: задать по вопросу на каждый элемент и сложить ответы самостоятельно |
| Даты | Читаются как текст, а не как упорядоченные величины: что раньше, сколько прошло, попадает ли в квартал — ненадёжно | Поручить модели вытащить месяц, число и год; арифметику оставить коду |
| Буквальность | Модель отвечает на вопрос, который вы написали, а не на тот, который имели в виду | Если, глядя на неверный ответ, вы объясняете, что на самом деле хотели спросить, — это объяснение и есть недостающая половина вопроса |
| Много лишнего в тексте | Точность падает, и труднее понять, какой кусок ответ испортил. В запрос помещается 64 тысячи токенов | Отправлять только то, что относится к вопросу |
| Арифметика между ответами | «Клиент просит вернуть деньги» и обратный ему «клиент просит что-то другое» на одном тикете дали 0,72 и 0,47 — в сумме 1,19 | Порог, подобранный на одной форме вопроса, на другую не переносить |
| Генерация текста | Модель не пишет строк совсем | Для всего, где нужен текст, ставить рядом большую модель |
Источник: документация TypeSafe, страница о слабых местах jev-1.13, проверка от 17 сентября 2026.
Про «ноль галлюцинаций»
Эту формулировку стоит развести на две, потому что в пересказах они слиплись. Первое утверждение: модель не может вернуть вариант, которого нет в вашем списке. Это верно, и опровергается оно одним случаем, когда так не вышло. Второе утверждение: выбранный вариант верен. Из первого оно не следует.
Сама TypeSafe пишет об этом прямо — ноль в их графике выведен из гарантии соответствия схеме, а не измерен на данных. В русскоязычном поле за первую неделю эту разницу оговорил один автор — Александр Горный.
Сюда же — замечание Уиллисона про чёрный ящик. Большую модель можно попросить объяснить ответ, и объяснение хотя бы будет. Jev возвращает число и молчит: если она пометила сообщение как спам, какие именно слова её к этому склонили, вы не узнаете.
Откуда берутся «в 193 раза быстрее»
Цифры 193,6 и 444,6 стоят на главной странице TypeSafe, и компания сама расшифровывает их в анонсе. Получены они на собственном наборе рабочих сценариев, эталонным ответом там считается среднее двух самых дорогих моделей рынка, а сценарии писала команда самой TypeSafe — об этом сказано в тексте, с оговоркой, что перекос возможен. И там же: «мы ожидаем, что это верхняя граница выигрыша в реальной работе». Отдельной строкой компания признаёт: доказать, что цена не субсидируется, она не может.
Сравнивать такие цифры стоит только со своим прогоном на своих данных. Благо это дёшево: как замечает Уиллисон, тысяча пробных запросов обходится в несколько центов.
- 01
Выпишите места, где решает правило
Пройдите по продукту и найдите каждую точку, где что-то выбирается: куда уходит обращение, что скрывается, что поднимается наверх, что помечается. Рядом с каждой — как решение принимается сейчас.
- 02
Выберите одно место, где правило ошибается чаще всего
То, про которое поддержка или модераторы говорят каждую неделю. Не самое важное — самое раздражающее.
- 03
Переформулируйте его в вопрос с готовым списком ответов
Одна из трёх форм: выбрать из списка, оценить по шкале, ответить да или нет. Если вопрос требует взвесить несколько вещей сразу — разбейте на несколько, по одному на каждую.
- 04
Соберите 100–200 своих строк с известным правильным ответом
Реальные тикеты, комментарии, лиды. Разметка уже есть — её сделали ваши же сотрудники за прошлый месяц.
- 05
Прогоните и сравните с текущим правилом на тех же строках
Прогон обойдётся в центы. Сравнивать нужно с тем, что стоит у вас сейчас: вендорские цифры получены на английских наборах и на чужих сценариях.
- 06
Поставьте пороги по цене ошибки
Для каждого действия отдельно, по таблице из раздела про уверенность. Начинайте с осторожных значений и опускайте по мере того, как накапливается статистика.
- 07
Ведите журнал
На каждое решение пишите ответ, вероятности и порог, который сработал. Без этого разобрать спорный случай через месяц будет нечем — модель объяснений не даёт.
Джон Берриман из Arcturus Labs разобрал, что OpenAI годами использует свои модели как скрытые классификаторы внутри собственных продуктов, и повторить такой сервис им технически несложно. Единственная защита, которую он у TypeSafe видит, — обучающие данные и способ обучения. Это довод в пользу того, чтобы строить у себя развилку на понятном интерфейсе, не привязываясь к одному поставщику.
За первую неделю появились открытые проекты того же класса, работающие на своём железе. Все они моложе десяти дней, и брать их в работу стоит с поправкой на возраст.
AnyJev
библиотека от исследовательского подразделения Nokia под лицензией Apache 2.0. Превращает любую открытую языковую модель в модель решений без дообучения и по дороге чинит два известных перекоса: тягу модели к отдельным вариантам независимо от текста и тягу к определённым позициям в списке.
Перейти →Laya
открытая модель решений на 421 млн параметров, помещается меньше чем в гигабайт памяти. На MacBook с процессором M4 без подключения к сети даёт около 45 решений в секунду.
Перейти →Kev
семейство моделей решений на базе Qwen 3.5 в трёх размерах: 0,8, 4 и 9 миллиардов параметров.
Перейти →JevBench
открытый бенчмарк, сравнивающий модели этого класса разом по точности, задержке и цене; прогон состоит из 534 решений. Ограничения автор называет сам: только английский язык и замер задержки с одного сервера в Германии.
Перейти →Часто задаваемые вопросы
- Чем Jev отличается от ChatGPT простыми словами?
ChatGPT пишет текст для человека, Jev выбирает один вариант из списка для программы. Ответа вне заданного списка Jev выдать не может по устройству, зато написать письмо или код она не умеет вовсе. Разница в скорости — 70–500 миллисекунд против 3–329 секунд; в цене входа — 4,2 цента за миллион токенов против 20 центов и выше.
- Правда ли, что Jev не галлюцинирует?
Гарантия здесь одна: модель не вернёт вариант, которого нет в вашем списке. Выбранный вариант при этом может быть неверным. Сама TypeSafe пишет, что ноль в их графике выведен из гарантии соответствия схеме, а не измерен на данных.
- Сколько это будет стоить на реальном объёме?
Вход стоит 4,2 цента за миллион токенов, выход бесплатен. Миллион токенов — примерно 700 тысяч слов. В демонстрации TypeSafe с игрой десять запросов в секунду обходились примерно в семь долларов за час непрерывной работы. Свою цифру считайте по своему объёму текста, а не по числу решений.
- Можно ли работать с Jev, не отправляя данные за границу?
С самим Jev — нет: это размещённый API, весов компания не публиковала. Для работы на своём железе есть открытые проекты того же класса: AnyJev от Nokia, Laya, Kev. Все они вышли в сентябре 2026 года, и зрелости у них соответствующая.
- Заменит ли такая модель большие нейросети в продукте?
Они делают разную работу и обычно стоят рядом. Типовая схема выглядит так: быстрая модель решений разбирает входящее и решает, куда его отправить, а большая модель включается только там, где нужен связный текст. В примере маршрутизации от TypeSafe из четырёх типов обращений до большой модели доходят два.
- С чего начать, если я не программист?
С первых двух шагов инструкции выше — их можно сделать без кода. Выпишите места в продукте, где решение принимает жёсткое правило, и отметьте то, где оно ошибается чаще всего. Этот список и есть техническое задание на проверку; дальше нужен человек, который прогонит двести ваших строк.
Список мест в продукте, где решение принимает жёсткое правило, полезен независимо от того, поставите вы туда модель, оставите правило или перепишете форму обращения, чтобы вопрос отпал. Этот список почти никогда не существует в явном виде: правила накапливаются годами, каждое кажется мелочью, и в сумме они определяют, каким продукт выглядит для пользователя. Час работы на такую опись окупается сам по себе.
А дальше дело за ценой. Пока одно решение стоило секунды и заметных денег, спорить о точности не приходилось: проще было оставить правило. При четырёх центах за миллион токенов двести своих строк вы прогоняете за вечер, и разговор переходит из области мнений в область замера.
Если хотите посмотреть, где в этой картине находитесь вы и ваша команда, — у нас есть карта уровней вайбкодинга с коротким тестом: пять ступеней от «собрал лендинг за вечер» до «держу собственные сервисы и агентов».
Запиши свой кейс на интенсиве
4 недели практики под кураторством. Реальный продукт + первые клиенты.